[경제일보] 카카오가 한국어 검색 성능과 추론 효율을 높인 임베딩 모델 2종을 오픈소스로 공개했다. 이용자의 질문과 관련 정보 사이의 의미적 유사성을 찾아내는 기술로, 개인화 인공지능(AI) 에이전트가 과거 대화나 흩어진 정보에서 필요한 맥락을 찾아 활용하는 데 쓰인다. 카카오는 자체 언어모델을 검색 기술로 확장하는 한편, 모델 크기와 벡터 차원을 조절할 수 있도록 해 다양한 서비스 환경에서의 활용 가능성을 높인다는 전략이다.
29일 카카오는 30억 파라미터 규모의 'Kanana-2-3b-embedding'과 13억 파라미터 규모의 'Kanana-2-1.3b-embedding'을 허깅페이스에 오픈소스로 공개했다고 밝혔다. 지난 7월 카나나 소형 언어모델(SLM) 4종을 공개한 데 이은 추가 공개다.
임베딩 모델은 텍스트의 의미를 수치로 표현해 질문과 관련 정보 사이의 유사성을 계산하는 기술이다. 일반적인 언어모델이 질문을 이해하고 답변을 생성하는 역할을 한다면, 임베딩 모델은 답변에 필요한 정보를 검색하는 과정에서 활용된다. 이용자가 정확한 단어나 명칭을 입력하지 않더라도 의미가 비슷한 정보를 찾아낼 수 있는 것이 특징이다.
예를 들어 이용자가 '전에 이야기했던 조용한 식당'을 찾는 경우, 식당 이름을 정확히 기억하지 못하더라도 과거 대화에 남아 있는 관련 표현을 검색해 필요한 정보를 찾는 데 활용할 수 있다. AI 에이전트가 이용자의 맥락을 반영해 답변하려면 질문에 응답하는 능력뿐 아니라 관련 정보를 적절히 검색하고 연결하는 능력도 필요하다. 카카오는 임베딩 기술을 개인화 AI 에이전트의 기반 기술 중 하나로 보고 있다.
◆ 한국어 검색 성능 개선…추론 효율도 강화
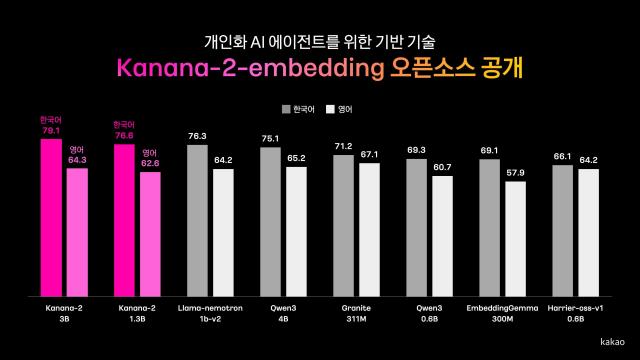
카카오는 이번에 공개한 두 모델이 유사 규모의 공개 임베딩 모델인 'llama-nemotron-embed-1b-v2', 'Qwen3-Embedding-4B'와 비교한 평가에서 한국어 성능이 가장 높았으며, 영어 성능은 유사한 수준을 보였다고 설명했다. Qwen3-Embedding과 비교해서는 높은 추론 효율을 기록했다고 강조했다. 기존 카나나 임베딩 모델 시리즈와 비교해 검색 성능을 개선하고 메모리 사용량과 추론 속도 측면에서도 수십 배 이상의 효율 향상을 기록한 것으로 나타났다.
모델 개발에는 카카오 자체 소형 언어 모델인 'Kanana-2-SLM'이 활용됐다. 카카오는 언어 모델의 언어 이해 능력을 정보 검색에 활용할 수 있도록 학습시켜 3B 모델을 개발했다. 이후 큰 모델이 학습한 정보를 작은 모델에 전달하는 지식 증류 기법을 적용해 1.3B 모델을 구축했다.
지식 증류는 상대적으로 큰 모델이 학습한 지식과 성능을 작은 모델에 전달하는 방식이다. 모델 규모를 줄이면서도 필요한 기능을 유지하도록 설계할 수 있어, 연산 자원과 메모리가 제한된 서비스 환경에서 활용 가능성을 높이는 데 쓰인다.
◆ 벡터 크기 조절 가능…오픈소스로 활용 확대
서비스 운영 환경에 맞춰 효율을 조정할 수 있는 기술도 적용했다. 카카오는 임베딩 벡터에서 사용하는 숫자의 개수를 조절할 수 있는 'MRL(마트료시카 표현 학습)' 기법을 도입했다.
임베딩 벡터는 텍스트의 의미를 숫자 배열로 나타낸 결과물이다. 벡터의 차원이 커지면 의미를 표현하는 데 활용할 수 있는 정보가 늘어날 수 있지만, 저장 공간과 연산 부담도 커질 수 있는 것으로 꼽힌다. MRL을 활용하면 개발자가 서비스에 필요한 검색 성능과 저장 공간, 처리 속도 등을 고려해 벡터 크기를 선택할 수 있다.
해당 방식은 대규모 검색 시스템부터 상대적으로 자원이 제한된 서비스까지 서로 다른 운영 조건에 대응할 수 있도록 하는 접근이다. 다만 벡터 차원을 줄였을 때 검색 정확도가 어느 정도 유지되는지, 실제 서비스에서 메모리와 처리 시간이 얼마나 줄어드는지는 구체적인 측정 결과를 통해 확인해야 한다.
카카오는 이번 모델에 연구·개발뿐 아니라 라이선스 조건에 따른 상업적 활용도 가능한 '카나나 오픈 라이선스'를 적용했다. 국내외 연구자와 기업이 모델을 직접 검증하고, 의미 기반 검색이나 개인화 AI 에이전트 개발에 활용할 수 있도록 개방한 것이다.
오픈소스 공개는 외부 개발자가 모델을 검증하고 각자의 서비스에 맞게 활용할 수 있는 기반을 제공한다. 카카오에게는 자체 개발한 모델을 외부 생태계에 개방해 활용 사례를 넓히고, 한국어 검색 기술의 적용 범위를 확대할 기회가 될 전망이다.
노병석 카카오 유니파이드 파운데이션 모델 성과리더는 "AI 에이전트가 이용자에게 필요한 도움을 제공하려면 질문에 답하는 능력과 함께, 흩어진 정보 속에서 필요한 정보를 정확히 찾아내는 기술이 중요하다"며 "이번 공개를 통해 연구자와 개발자들이 한국어에 강점을 가진 임베딩 기술을 다양한 서비스에 활용할 수 있도록 돕고, 검색 성능과 효율을 함께 높이는 연구를 이어갈 것"이라고 말했다.









댓글 더보기